LLM (Large Language Model) 이란?
LLM(Large Language Model)은 엄청난 양의 텍스트로 학습해서, 주어진 글 다음에 올 단어(토큰)를 예측하는 모델이다.
예를 들어, "오늘 날씨가 정말 장원영이다." 이라는 입력을 받으면, 모델은 다음에 올 수 있는 단어들의 확률을 계산한다.
- 좋다: 40%
- 덥다: 25%
- 춥다: 20%
- 나머지 수 많은 후보: 15% (이 안에 장원영도 있다 ㅋㅋㅋ)
즉, LLM의 본질은 "다음 토큰의 확률분포를 출력하는 함수"다. 확률분포이므로 전부 더하면 반드시 100%가 된다. 모델이 합을 1로 맞춰주는 계산이 뒤에서 나올 softmax다.
이해 포인트
- ChatGPT나 Claude가 "생각해서 답한다"기 보다, 다음 토큰을 계속 골라 이어 붙이는 구조라는 게 핵심
- "Large"는 두 가지를 뜻한다. 학습 데이터가 크고, 모델 파라미터(내부 숫자)가 많다는 것.
- "토큰"은 단어와 비슷하지만 똑같지 않은 텍스트 조각.
답변이 만들어지는 과정
LLM이 답변을 만드는 과정은 반복문과 비슷하다.
1. 입력 텍스트를 토큰으로 쪼갠다
2. 모델이 다음 토큰의 확률분포를 계산한다.
3. 그중 하나를 골라 (샘플링) 뒤에 붙인다.
4. 붙인 결과를 다시 입력으로 넣고 2번 반복한다.
5. 종료를 뜻하는 토큰이 나오면 멈춘다.
출력을 하는 답변은 이렇게 토큰을 한 개씩 이어 붙인 결과다. ChatGpt 답변이 글자가 흘러나오듯 출력되는 것도 이 때문이다.
- LLM은 크게 두 단계를 거쳐 만들어진다.
사전학습(Pre-training) : 방대한 텍스트에서 "다음 토큰 맞추기" 를 반복하며 언어의 패턴과 지식을 익힌다.
후속학습(Post-training) : 사람이 원하는 방식 (질문에 답하기, 안전하게 말하기 등) 으로 행동하도록 추가 조정한다.
사전학습만 마친 모델은 글을 이어 쓰는 데 가깝고, 후속 학습을 거쳐야 우리가 아는 챗봇처럼 대화한다.
예제 실행
1. 라이브러리 설치
py -3.12 -m pip install transformers torch2. Python 파일 만들기
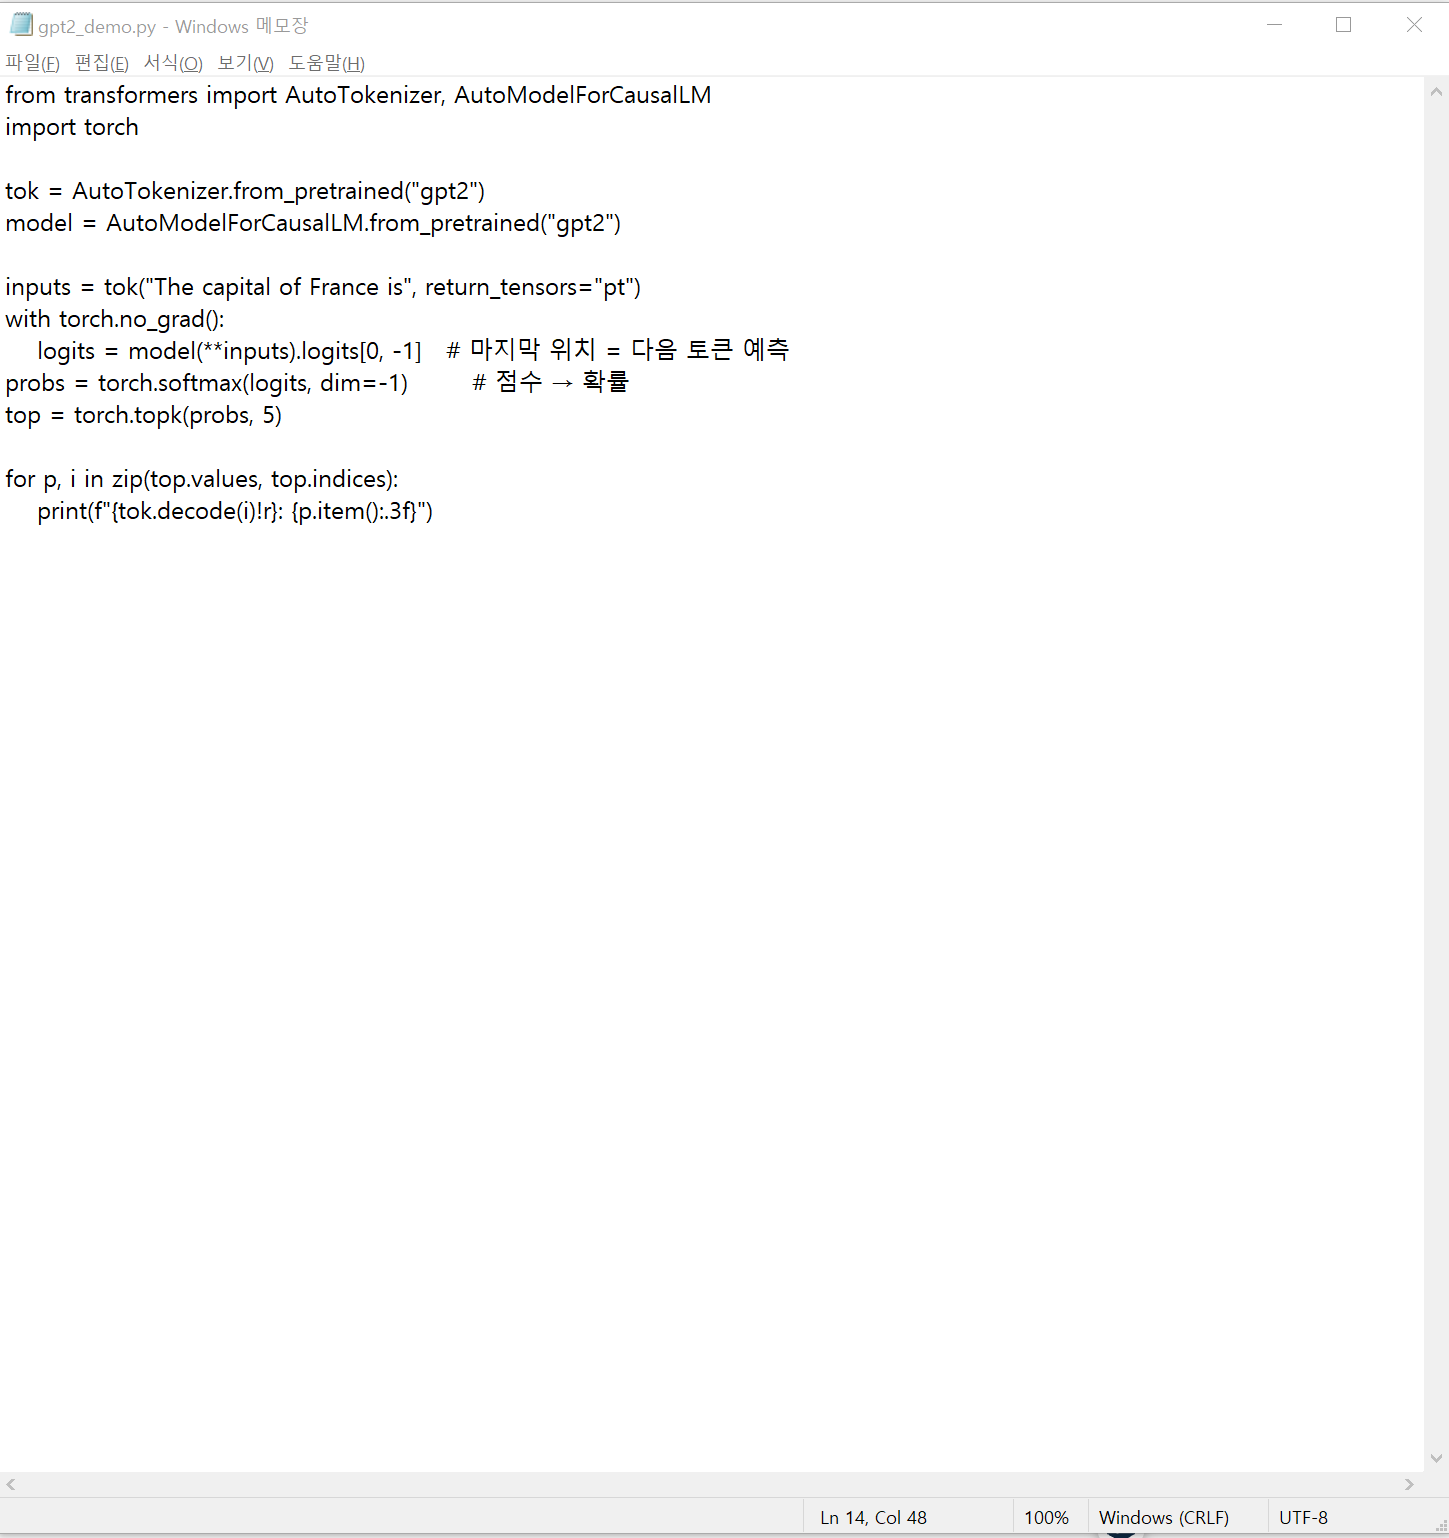
notepad gpt2_demo.py메모장
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

tok = AutoTokenizer.from_pretrained("gpt2")
model = AutoModelForCausalLM.from_pretrained("gpt2")
model.eval()

inputs = tok("The capital of France is", return_tensors="pt")

with torch.no_grad():
    logits = model(**inputs).logits[0, -1]
    probs = torch.softmax(logits, dim=-1)
    top = torch.topk(probs, 10)

for p, i in zip(top.values, top.indices):
    print(f"{tok.decode(i.item())!r}: {p.item():.4%}")
메모장을 저장하고 닫은 뒤, CMD에서 실행
py -3.12 gpt2_demo.py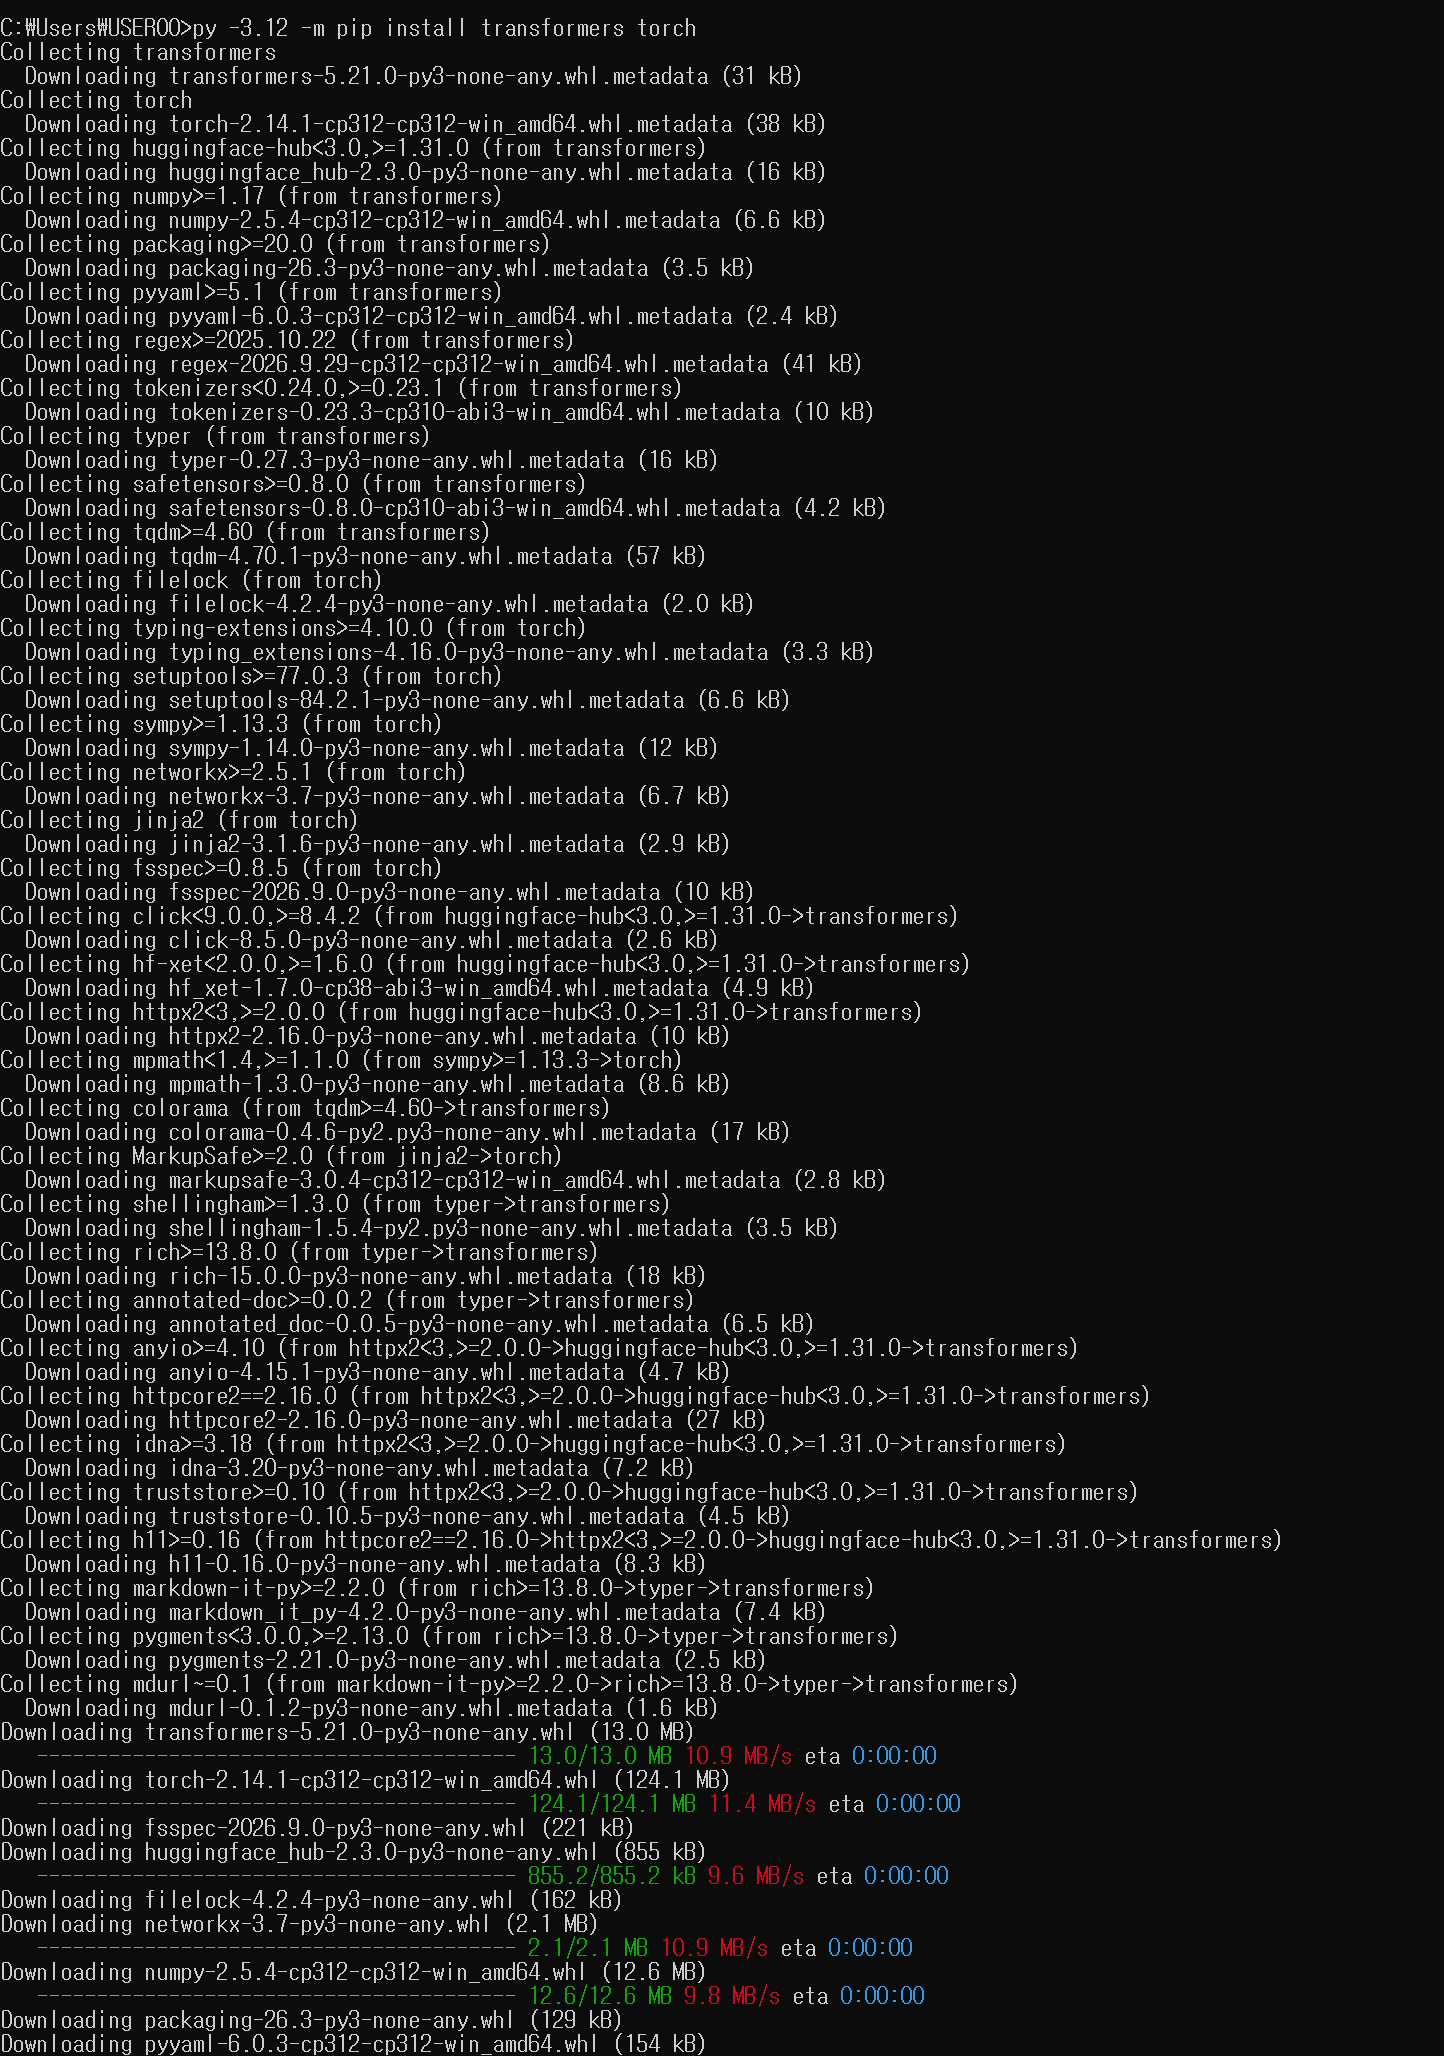
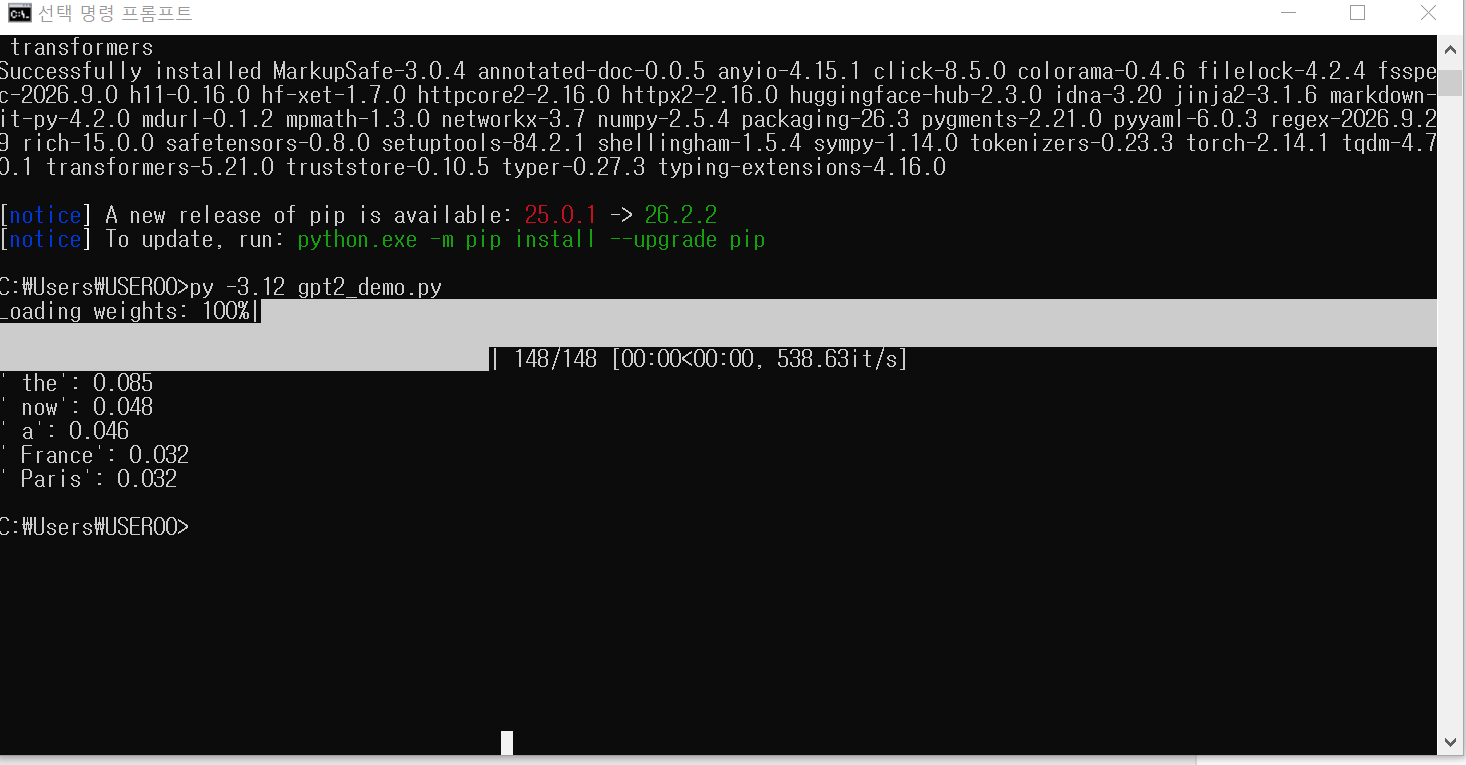
입력 문장 : The capital of France is
| 다음 토큰 후보확률 | 확률 |
| the | 8.5% |
| now | 4.8% |
| a | 4.6% |
| France | 3.2% |
| Paris | 3.2% |
실행 결과 해석
- 상위 5개 확률을 다 더해도 24.3%. 나머지 76%는 GPT-2 의 어휘 약 5만개 토큰에 흩어져 있다. 1등조차 8.5%라는 건 "확률분포"가 실제로 이렇게 넓게 퍼진 형태라는 뜻
- GPT - 2 는 사전학습만 마친 모델, 그래서 "프랑스의 수도는?" 에 답하기 보다는 문장을 이어쓰는 쪽으로 답하고, Paris가 5위에 머무는 거다. 앞에서 쓴 "사전학습 vs 후속 학습" 설명이 이 결과로 증명되는 셈이다.
- 토큰 앞의 공백: 콘솔 출력을 보면 ' the' 처럼 공백이 붙어 있는데, 토큰이 단어와 똑같지 않다는 증거이다.
코드 이해
from transformers import AutoTokenizer, AutoModelForCausalLM
import torch

tok = AutoTokenizer.from_pretrained("gpt2")
model = AutoModelForCausalLM.from_pretrained("gpt2")

inputs = tok("The capital of France is", return_tensors="pt")
with torch.no_grad():
    logits = model(**inputs).logits[0, -1]   # 마지막 위치 = 다음 토큰 예측
probs = torch.softmax(logits, dim=-1)        # 점수 → 확률
top = torch.topk(probs, 5)

for p, i in zip(top.values, top.indices):
    print(f"{tok.decode(i)!r}: {p.item():.3f}")
- logits: 모델이 어휘 전체 토큰에 매긴 원점수입니다.
- softmax: 그 점수를 합이 1인 확률로 바꾼다.
- topk(5) : 확률 상위 5개 토큰을 뽑는다.
- GPT-2는 오래된 작은 모델이라 정답이 1등이 아닐 수도 있다. "작은 모델은 이정도, 큰 모델은 더 정확하다"
그래서 서비스를 만들 때 중요한 점
1. 환각: LLM은 사실을 조회하는 게 아니라 그럴듯한 토큰을 생성한다. -> 외부 문서를 붙여주는 RAG가 필요한 이유.
2. 비결정성: 샘플링 때문에 같은 입력에도 출력이 달라 질 수 있다. -> 테스트와 평가 방식이 달라진다.
3. 상태없음: 모델은 이전 대화를 기억하지 않고, 매번 이전 내용을 다시 입력에 넣어줘야 한다. -> 컨텍스트 윈도우 한계
4. 토큰 과금: 입력과 출력 토큰 수에 따라 비용이 정해진다 -> 프롬프트 길이와 비용 관리
오늘의 한 줄 정리: LLM은 다음 토큰의 확률분포를 예측하는 모델이고, 답변은 그 예측을 반복해서 이어 붙인 결과다.
'AI' 카테고리의 다른 글
| AI 공부하기 1-3. 임베딩 (0) | 2026.11.01 |
|---|---|
| AI 공부하기 1-2. 토큰과 토크나이저 (1) | 2026.10.30 |