임베딩이란?
텍스트는 토크나이저를 거쳐 토큰ID(정수)로 바뀐다. 그런데 ID는 번호일 뿐이라 번호 사이에 의미 관계가 없다.
모델은 이 ID를 그대로 계산하지 않고, 먼저 벡터(실수 배열)로 바꾼다. 이 변환이 임베딩이다.
토큰 ID -> (임베딩 테이블 조회) -> 벡터 -> 모델 계산
- 임베딩 테이블: 어휘 크기 x 차원 크기의 표. GPT-2는 50,257 x 768
- 토큰 ID는 이 표의 행 번호다. 4881번 토큰의 벡터는 4881번 행이다.
- 표의 값은 사람이 정하지 않는다. 모델 학습 중에 파라미터로 함께 학습된다.
엑셀 시트로 보면 이해가 쉽다. 행은 토큰의 종류, 열은 숫자 개수고, 한 행이 곧 하나의 벡터다. 아래는 토큰 5종류, 숫자 3개짜리 미니표다.
EX)
| 행 번호 (토큰 ID) | 벡터 |
| 0 | [0.2, -0.5, 0.9] |
| 1 | [0.7, 0.1, -0.3] |
| 2 | [-0.4, 0.8, 0.5] |
| 3 | [0.0, 0.3, 0.3] |
| 4 | [0.9, 0.9, -0.1] |
- ID 2를 조회하면 2번 행 [-0.4, 0.8, 0.5] 가 나온다. 계산이 아니라 행을 읽어오는 것이다.
- GPT-2 의 실제 표는 이것이 행 5행X3열이 아니라 50,257행 X 768열일 뿐
이해 포인트
- 백엔드 관점으로는 ID로 벡터를 조회하는 Map<Integer, float[768]> 와 같은 구조다. 값을 학습으로 채운다는 점이 다르다.
- 토큰 ID는 상품코드와 같다. 코드 숫자의 크기에는 의미가 없고 구분용 이름표일 뿐. 이름표는 의미 있는 계산을 할 수 없어서, 계산에 쓸 수 있는 숫자 묶음(벡터)으로 바꾸는 단계가 필요하다.
- 실제 표는 50,257 X 768 = 38,597,376칸이다. 사람이 채울 수 없고 학습이 채운다.
- 토크나이저가 "문자열 -> ID"라면, 임베딩은 "ID -> 벡터"다. 두 단계가 이어져 모델의 입구가 된다.
왜 번호가 아니라 벡터인가?
번호는 크기 비교 외에 정보가 없다. 벡터는 좌표라서 방향과 거리를 잴 수 있다.
- 지도의 좌표와 같다. 도시 이름만으로는 두 도시가 가까운지 알 수 없지만, 위도와 경도가 있으면 거리를 계산 할 수 있다. 임베딩은 이 좌표가 2개가 아니라 768개다.
학습 결과 비슷한 문맥에서 쓰이는 토큰은 가까운 벡터를 갖는 경향이 있다. 가까운 정도는 보통 코사인 유사도로 잰다.
- 코사인 유사도: 두 벡터가 같은 방향을 향하는 정도. 범위는 -1 ~ 1 이다.
- 1에 가까울수록 방향이 비슷하고, 0 근처면 방향 관계가 거의 없다.
- 길이는 무시하고 방향만 비교한다.
EX)
| 단어 | 좌표 |
| France | (0.9, 0.8) |
| Paris | (0.8, 0.9) |
| apple | (-0.5, 0.2) |
- France와 Paris의 코사인 유사도는 약 0.99다. 두 좌표가 거의 같은 방향이다.
- France와 apple은 약 -0.45다. 방향이 어긋난다.
- France를 2배로 늘린 (1.8, 1.6) 과 France의 유사도는 1이다. 길이가 달라도 방향이 같으면 1이다.
- 실제 계산은 2차원이 아니라 768차원에서 하는 것 뿐이다,.
이해포인트
- "의미가 비슷하다"는 사람이 정의한 것이 아니다. 비슷한 문맥에 등장하는 토큰이 비슷한 위치로 모이는 학습 결과다.
- 벡터의 768개 값은 칸마다 사람이 붙인 의미(무게, 색 같은 속성)가 없다. 의미는 값 하나가 아니라 768개 전체의 조합에 있다.
- 이 개념이 RAG의 의미 기반 검색으로 이어진다.
임베딩의 두 가지 의미
| 구분 | 입력 | 용도 |
| 토큰 임베딩 (이번 글) | 토큰 하나 | LLM 내부, 모델의 첫 단계 |
| 문장/문서 임베딩 | 문장, 문서 전체 | 검색, 유사도 비교, RAG |
- RAG에서 쓰는 것은 문장/문서 임베딩이다.
- 토큰 임베딩이 재료 하나의 성분표라면, 문장/문서 임베딩은 완성된 요리 한 접시의 맛 프로필에 가깝다.
실행 예제
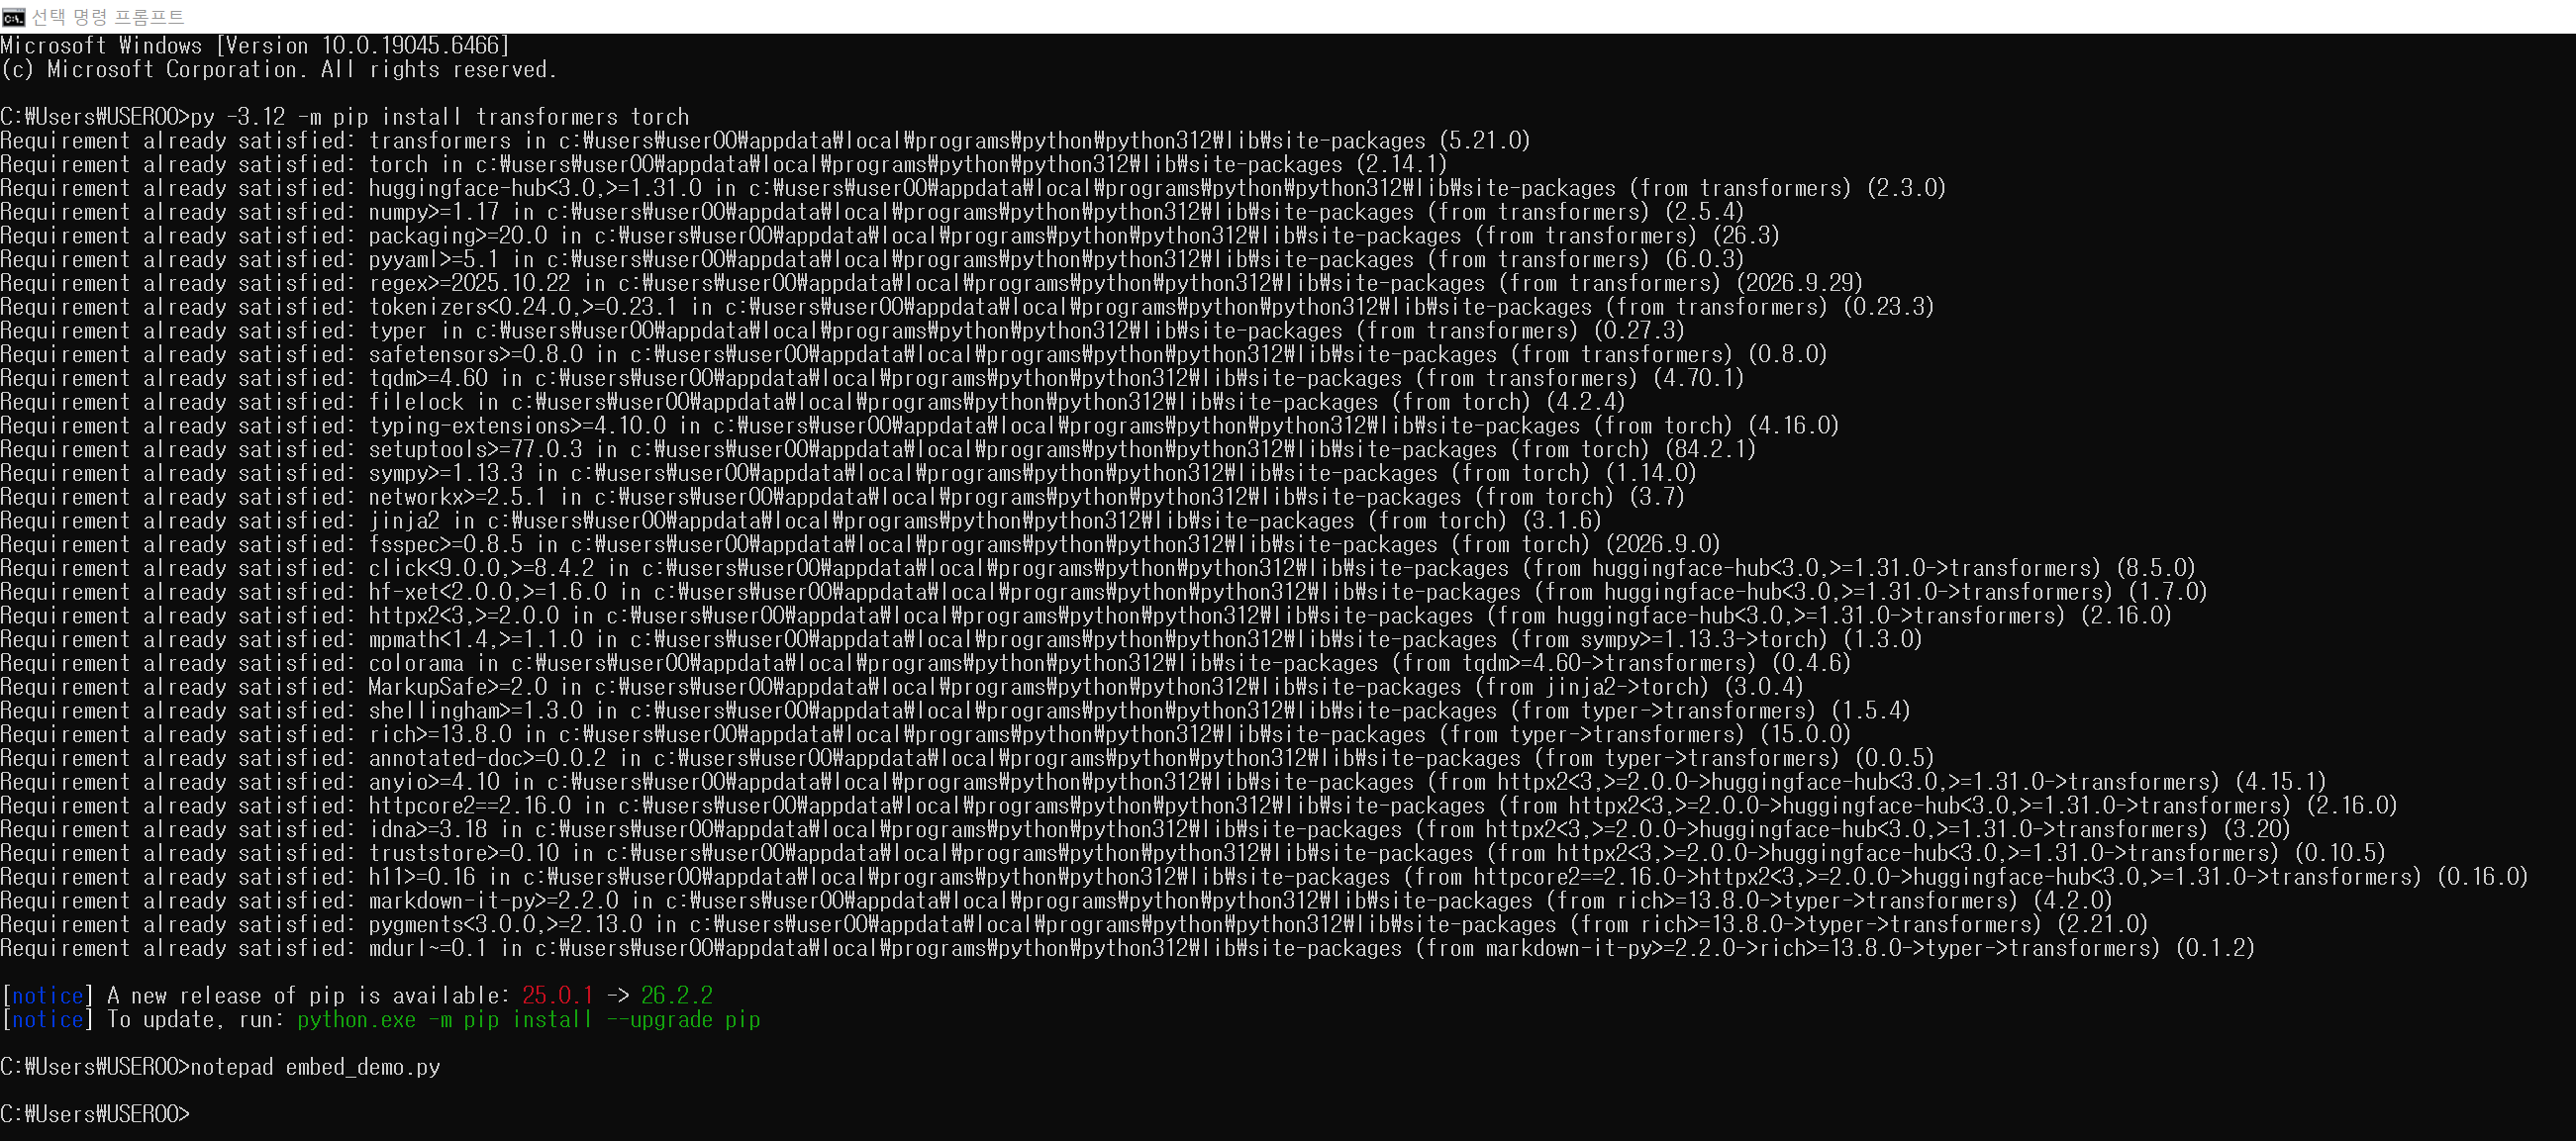
transformers, torch가 설치되어 있어야 한다. 없으면 먼저 설치한다.
py -3.12 -m pip install transformers torch
notepad embed_demo.py
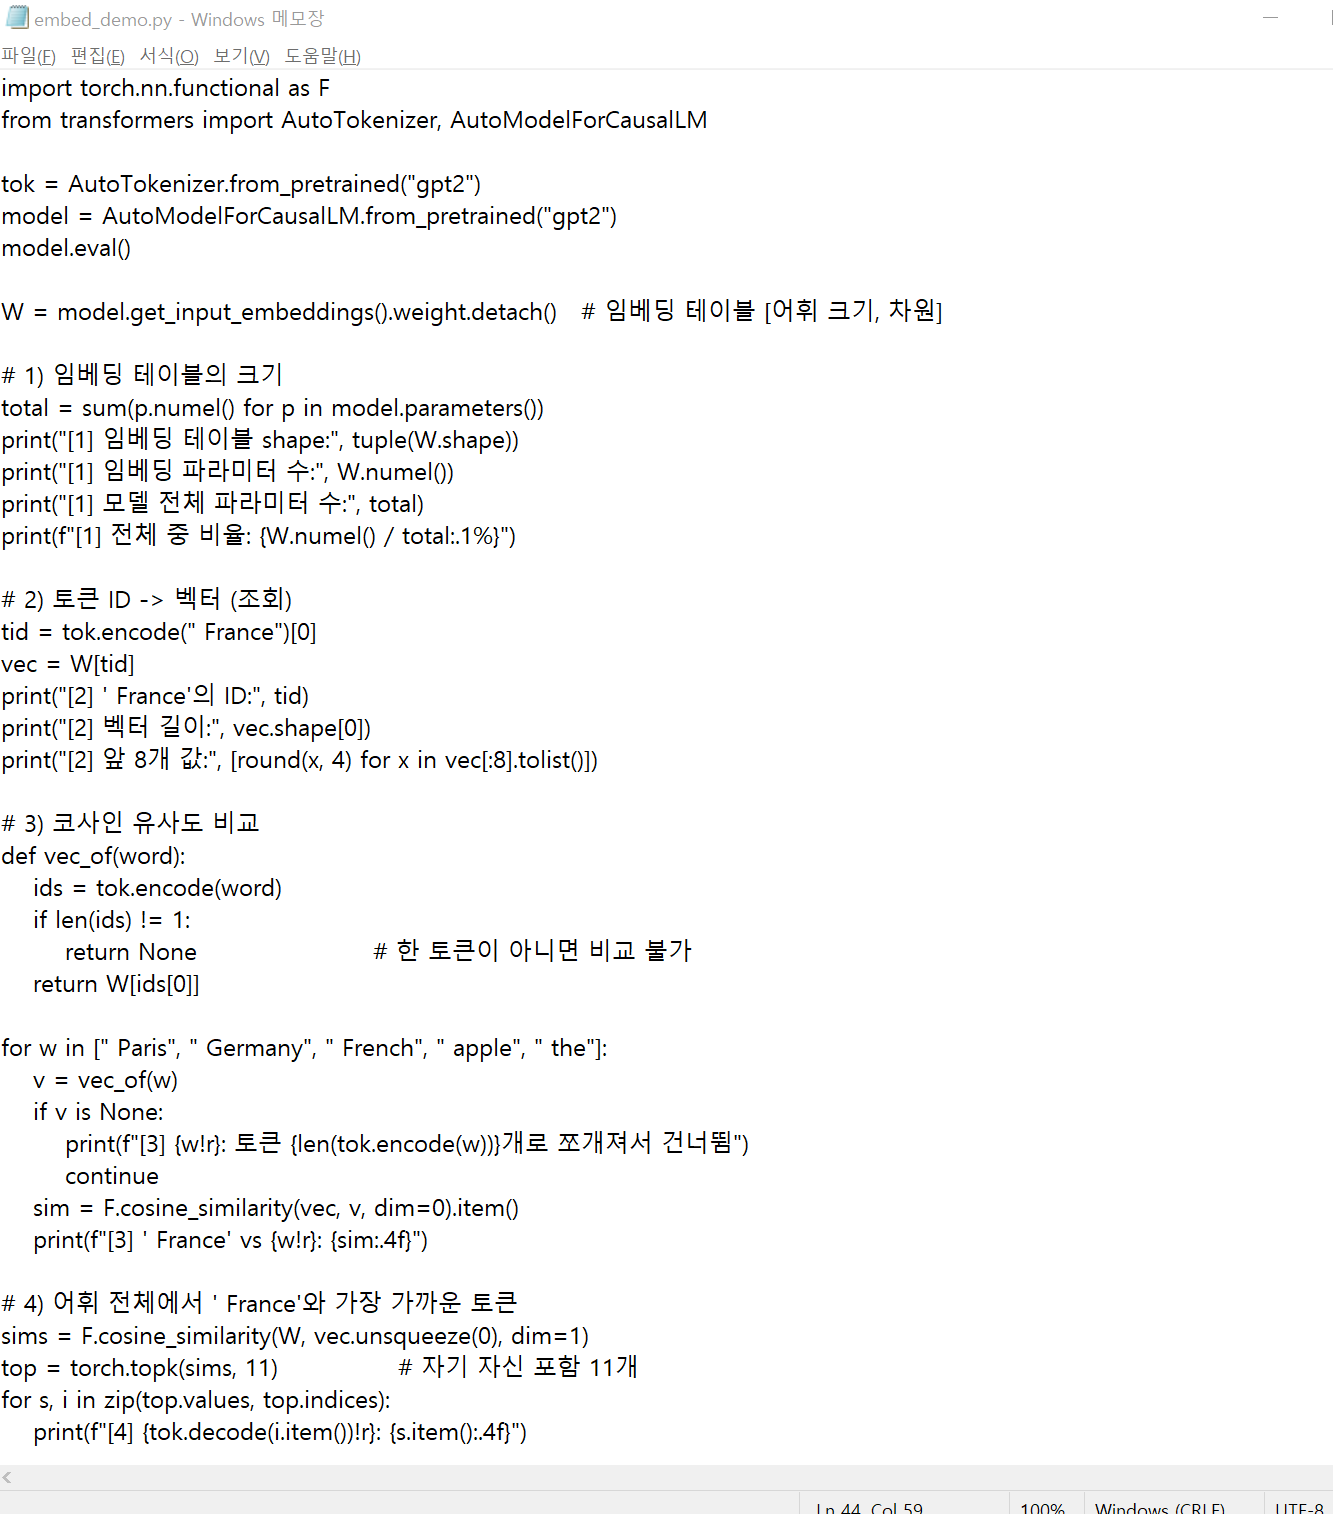
embed_demo.py
import torch
import torch.nn.functional as F
from transformers import AutoTokenizer, AutoModelForCausalLM

tok = AutoTokenizer.from_pretrained("gpt2")
model = AutoModelForCausalLM.from_pretrained("gpt2")
model.eval()

W = model.get_input_embeddings().weight.detach()   # 임베딩 테이블 [어휘 크기, 차원]

# 1) 임베딩 테이블의 크기
total = sum(p.numel() for p in model.parameters())
print("[1] 임베딩 테이블 shape:", tuple(W.shape))
print("[1] 임베딩 파라미터 수:", W.numel())
print("[1] 모델 전체 파라미터 수:", total)
print(f"[1] 전체 중 비율: {W.numel() / total:.1%}")

# 2) 토큰 ID -> 벡터 (조회)
tid = tok.encode(" France")[0]
vec = W[tid]
print("[2] ' France'의 ID:", tid)
print("[2] 벡터 길이:", vec.shape[0])
print("[2] 앞 8개 값:", [round(x, 4) for x in vec[:8].tolist()])

# 3) 코사인 유사도 비교
def vec_of(word):
    ids = tok.encode(word)
    if len(ids) != 1:
        return None                      # 한 토큰이 아니면 비교 불가
    return W[ids[0]]

for w in [" Paris", " Germany", " French", " apple", " the"]:
    v = vec_of(w)
    if v is None:
        print(f"[3] {w!r}: 토큰 {len(tok.encode(w))}개로 쪼개져서 건너뜀")
        continue
    sim = F.cosine_similarity(vec, v, dim=0).item()
    print(f"[3] ' France' vs {w!r}: {sim:.4f}")

# 4) 어휘 전체에서 ' France'와 가장 가까운 토큰
sims = F.cosine_similarity(W, vec.unsqueeze(0), dim=1)
top = torch.topk(sims, 11)               # 자기 자신 포함 11개
for s, i in zip(top.values, top.indices):
    print(f"[4] {tok.decode(i.item())!r}: {s.item():.4f}")
실행
py -3.12 embed_demo.py
한글이나 특수문자가 깨지면 'chcp 65001'을 먼저 입력한 뒤 다시 실행해야 한다.
코드 이해
- get_input_embeddings().weight: 모델 안의 임베딩 테이블. [50257, 768] 모양의 표다.
- W[tid]: ID로 행 하나를 읽는다. 이것이 임베딩 조회다.
- cosine_similarity(vec, v, dim=0): 벡터 두 개의 방향이 얼마나 같은지 계산한다.
- cosine_similarity(W, vec.unsqueeze(0), dim=1): 어휘 전체를 한 번에 비교한다.
- 한 토큰이 아니면 건너뛰는 이유: 토크나이저가 단어를 여러 조각으로 쪼갤 수 있기 때문이다.
결과 해석
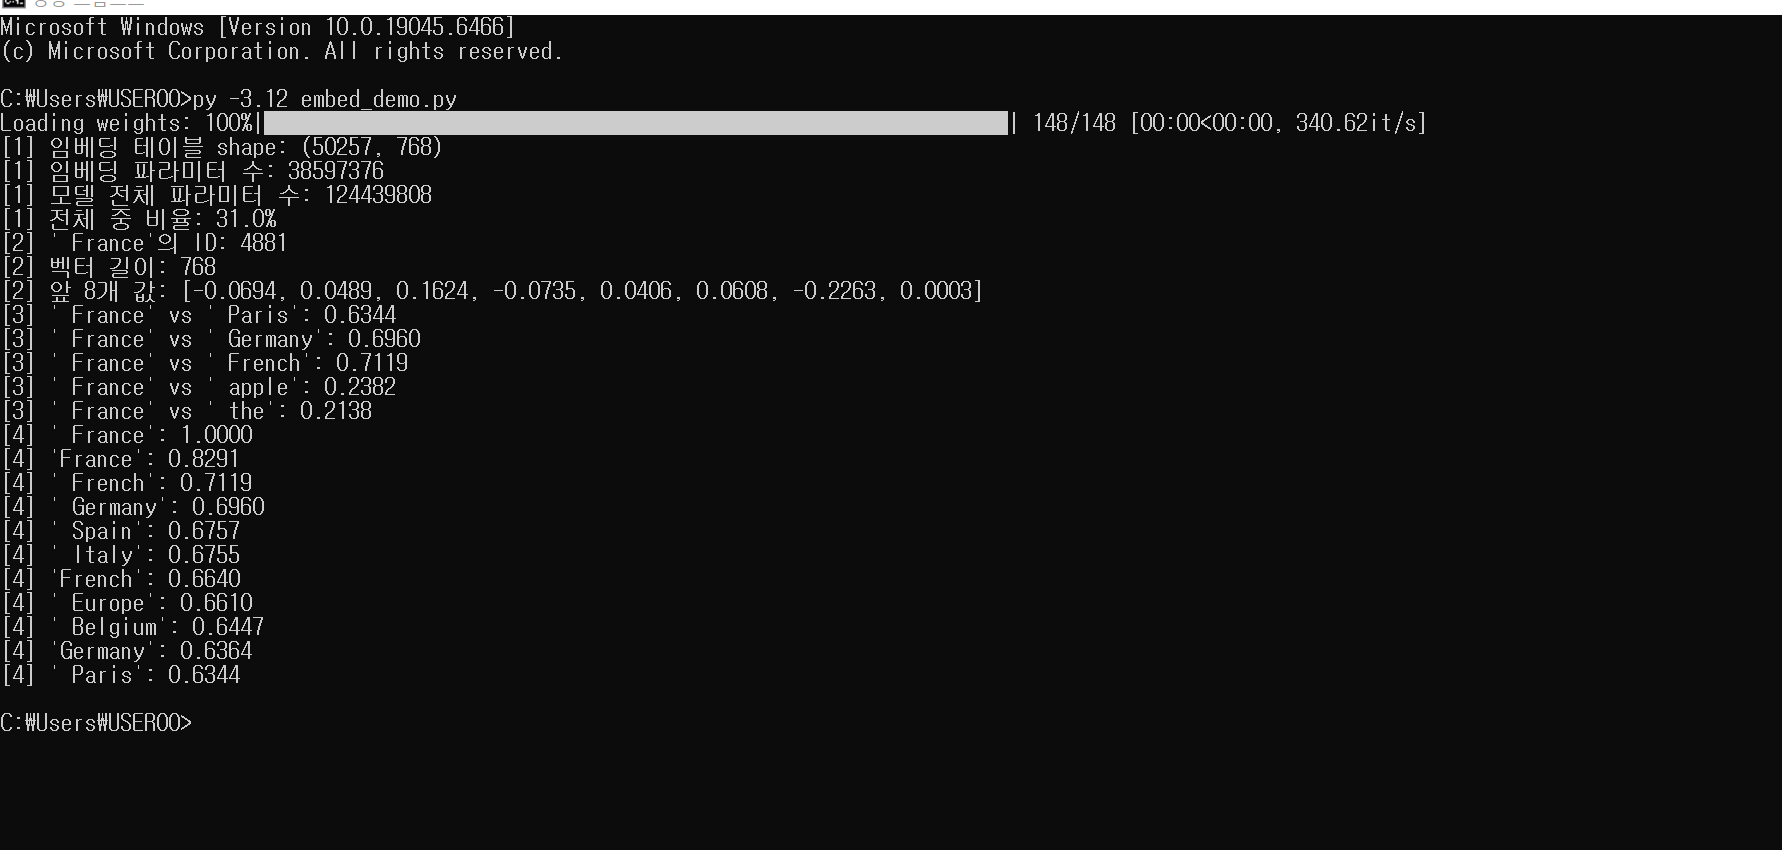
[1] 테이블 크기
- 임베딩 테이블 shape는 (50257, 768) 이고, 파라미터는 38,597,376개다. 모델 전체 124,439,808개의 31.0%다.
- 50,257 X 768 = 38,597,376 이다. 실행 결과와 일치한다.
- 모델 파라미터의 31%가 토큰 ID를 벡터로 바꾸는 표 하나에 들어 있다.
[2] 테이블 크기
- 'France' 의 ID는 4881 이고, 벡터 길이는 768이다. 앞 8개 값은 [-0.0694, 0.0489, 0.1624, -0.0735, 0.0406, 0.0608, -0.2263, 0.0003]이다.
- 값 하나하나 해석 할 수 없다. 의미는 값 하나가 아니라 벡터 전체의 위치에 있다.
[3] 코사인 유사도
| 비교 대상 | 코사인 유사도 |
| 'Paris' | 0.6344 |
| 'Germany' | 0.6960 |
| 'French' | 0.7119 |
| 'apple' | 0.2382 |
| 'the' | 0.2138 |
- 'France' 와 가장 비슷하게 나온 것은 'French' (0.7119) 이고, 가장 낮은 것은 'the' (0.2138)다.
- Paris, Germany, French 는 0.63 ~ 0.71 이고, 관련 없는 apple, the 는 0.21~0.24다. 의미가 가까운 토큰일수록 유사도가 높다.
- 관련 없는 토큰도 0이 아니라. 0.2 수준이 나왔다. 유사도는 절대값보다 상대 순위로 본다.
- 수도인 'Paris' (0.6344) 는 'Germany' (0.6960), 'French' (0.7119) 보다 낮다.
[4] 가장 가까운 토큰
| 순위 | 토큰 | 코사인 유사도 |
| 1 | ‘ France’ (자기 자신) | 1.0000 |
| 2 | ‘France’ | 0.8291 |
| 3 | ‘ French’ | 0.7119 |
| 4 | ‘ Germany’ | 0.6960 |
| 5 | ‘ Spain’ | 0.6757 |
| 6 | ‘ Italy’ | 0.6755 |
| 7 | ‘French’ | 0.6640 |
| 8 | ‘ Europe’ | 0.6610 |
| 9 | ‘ Belgium’ | 0.6447 |
| 10 | ‘Germany’ | 0.6364 |
| 11 | ‘ Paris’ | 0.6344 |
- 어휘 50,257개 중 상위 11개다. 1등은 자기 자신이고, 나머지 10개는 모두 나라, 국적, 유럽, 프랑스와 관련있는 토큰이다.
- 2위는 공백 없는 'France' (0.8291) 다. 공백 유무에 따라 서로 다른 토큰인데도 벡터는 가깝다. 'French', 'Germany' 도 공백 없는 형태로 함께 올라와 있다.
- 'Paris' 는 11개 중 마지막이다.
- France는 수도(Paris) 보다 같은 범주(나라, 국적)의 단어와 더 가깝게 놓여 있다.
토큰 임베딩은 문맥을 모른다
중요!
- 토큰 임베딩은 문맥과 무관한다. 같은 토큰이면 항상 같은 벡터다.
- 국어사전에서 "배"를 찾으면 항상 같은 설명이 나오는 것과 같다. 문장 속에서 어떤 뜻인지는 사전이 아니라 문장을 읽어야 정해진다.
- "bank"가 은행인지 강둑인지는 이 단계에서 구분하지 못한다.
- 문맥에 따라 벡터가 바뀌는 과정은 Transformer 층의 Attention에서 일어난다.
- 순서 정보도 임베딩 테이블만으로는 알 수 없다. GPT-2는 위치 정보를 별도로 더한다.
서비스를 만들 떄 중요한 점
1. 벡터 저장 크기를 제한 할 수 있다. 768차원 float32 벡터 하나는 768 × 4 = 3,072바이트(약 3KB)다. 100만 개를 저장하면 약 3GB다. 차원이 2배면 저장 크기도 2배다. 차원은 임베딩 모델마다 다르다.
2. 임베딩 모델을 바꾸면 기존 벡터를 쓸 수 없다. 벡터는 모델 기준으로만 비교할 수 있어서, 모델을 교체하면 전체를 다시 임베딩해야한다.
3. 검색 방식이 달라진다. 키워드 검색(LIKE, 역색인)은 단어가 일치해야 찾고, 벡터 검색은 의미가 가까운 것을 찾는다. RAG의 출발점이다.
'AI' 카테고리의 다른 글
| AI 공부하기 1-2. 토큰과 토크나이저 (1) | 2026.10.30 |
|---|---|
| AI 공부하기 1-1.LLM이란 무엇인가 (0) | 2026.10.29 |